
任せたい仕事から考える
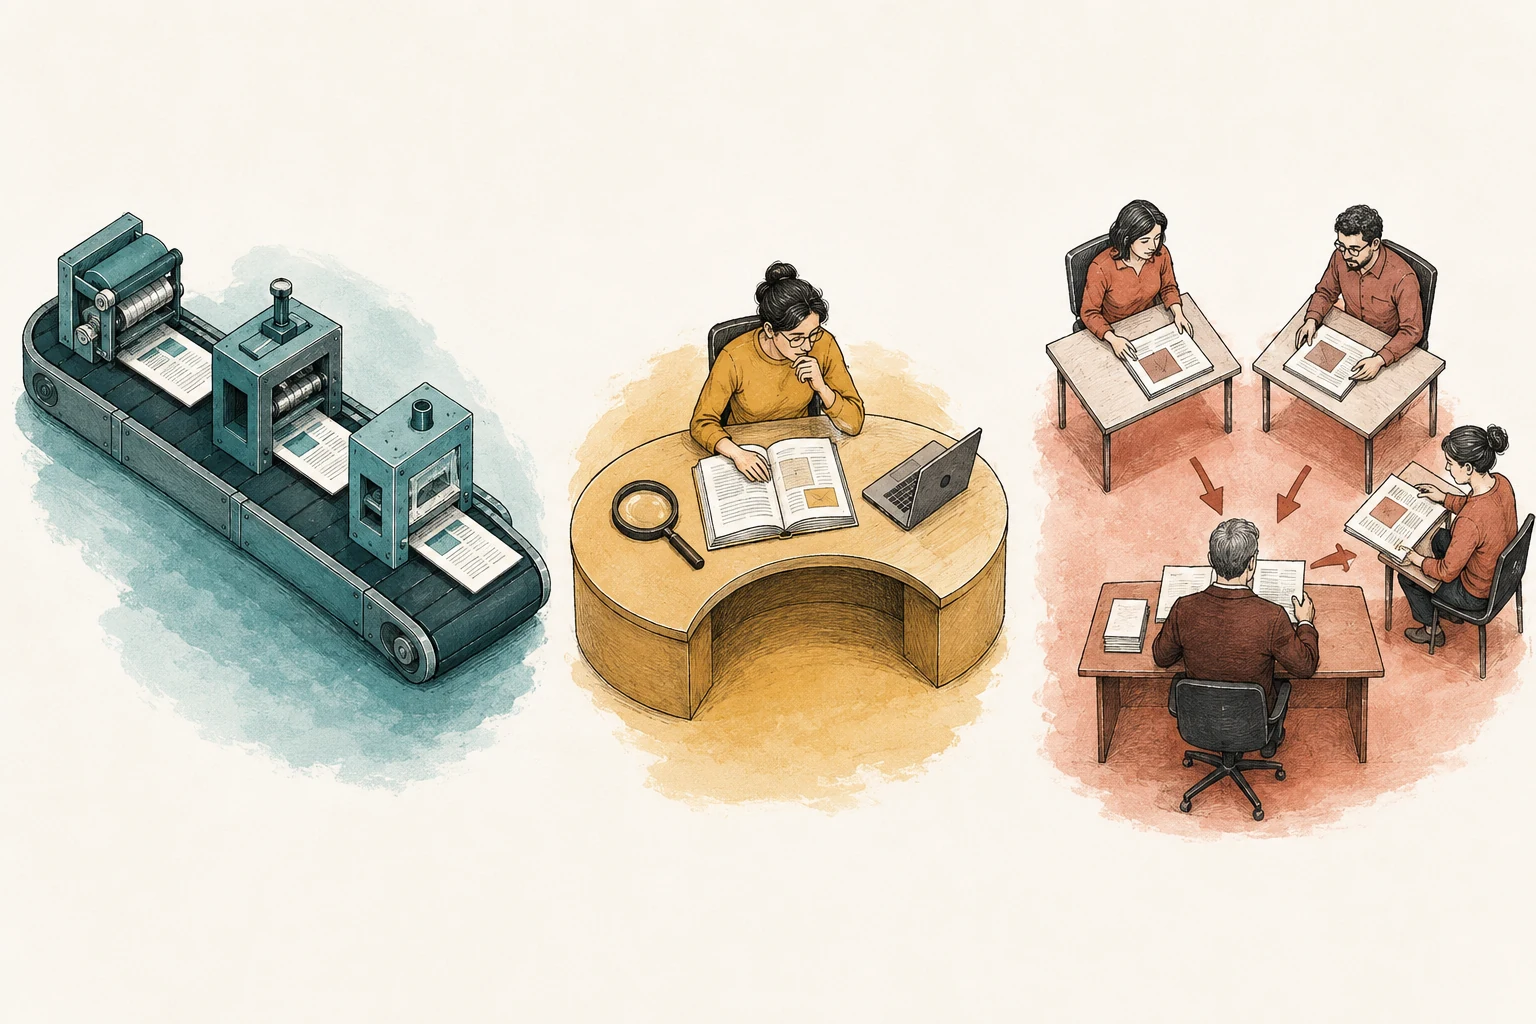
月次報告なら、数値を集め、確認し、ひな型へ入れる順序が決まっています。未知のソフトウェア障害では、調べないと次の作業が分かりません。複数地域の調査なら、別々の検索を同時に進められます。必要な柔軟さは仕事によって違います。
ワークフローは開発者が定めた経路を進みます。エージェントは前の結果から次の行動を選べます。複数なら分担できますが、結果をまとめる人や仕組みが必要です。AnthropicとOpenAIの指針は、単純な構成から始め、課題に必要な場合に複雑さを加えるよう勧めます。[1][2]
担当を増やして何を改善したいかを書きます。検索の速さ、異なる出典を調べる範囲、独立した確認の質などです。改善の確認方法も決めます。普通のコードやチェックリストで足りるなら、それを使います。各工程にエージェントという名前を付けても、効果があるとは限りません。
仕事に合わせて構成を選び、何が改善したか測ります。
手順が分かるならワークフローを使う
月次報告では、記録取得、項目抽出、合計の確認、説明文の作成、出力の確認と順序を指定できます。コードで順序を守り、必須項目がなければ止められます。人の承認を入れる場所も明確です。
ワークフローの中でもモデルに判断を頼めます。文書分類、段落の下書き、資料が主張を支えるかの確認などです。確認に失敗した工程を繰り返すこともできます。使える経路と繰り返しの終了条件を開発者が決める点が違います。
入力と完了基準が分かる仕事に向いています。計算、アクセス確認、重複検出はコード、解釈が必要な箇所はモデルを使います。例外のたびに新しい経路が必要なら、その部分を特定します。全体を置き換えず、不確かな工程だけ限定したエージェントに任せられます。
前の結果で次が決まるなら、一つのエージェントを使う
障害調査ではログを読み、原因を考え、試し、方向を変える必要があります。すべての経路を先に並べるのは現実的ではありません。ツールを選び、結果を調べさせることで対応の余地が生まれます。
一つのエージェントなら、目的、根拠、失敗した試み、未解決の問いをまとめて保持できます。各工程で直前の詳細が必要な場合、分担すると同じ説明を繰り返し、引継ぎで情報を落とすことがあります。
目的、許可するツール、進捗記録、完了や助けを求める条件を与えます。課題に合う時間や費用の上限を決めます。調査に必要なアクセスから始め、公開や削除などは別に許可します。次の行動を選ばせることと、無制限の権限を与えることは違います。
同じ情報が必要な工程は、まとめて進めます。
仕事を分けられるなら担当を増やす
複数地域の調査なら、同じ問いと報告形式で一地域ずつ任せられます。他地域の途中結果を逐一必要としないため、同時に進められます。最後に主担当が範囲を確認し、知見をまとめます。
Anthropicは主担当と補助エージェントを使った内部の調査評価で、単独構成より90.2%改善したと報告しています。一方、複数エージェントは通常のチャットの約15倍のトークンを使い、トークン使用量が性能のばらつきの多くを説明したとも述べています。[3] トークンはモデルの入出力を処理する単位です。試したシステムと課題の結果であり、人数だけが改善の原因とも、すべての仕事に有効とも言えません。
分担前に、各依頼を書いてみます。短い説明で着手し、ほかの担当から絶えず更新を受けずに終え、確認できる結果を返せるでしょうか。重要な細部を失わず統合できるでしょうか。難しければ依存する工程はまとめます。別々のメッセージに分けても、独立して働けるとは限りません。
結果の確認と統合の方法を決める
担当が別々に作業して結果を返す、主担当が割当てを調整する、担当同士で直接情報交換する、といった形があります。構成で、誰が誤りを見つけられるかが変わります。調整役も、答えを素通りさせず実際に確認してこそ役立ちます。
エージェント構成の拡張を調べた研究の2025年初版は、4つのベンチマークで180構成を試しました。分割できる金融課題では中央の調整が有効でしたが、順に計画する課題では、試した複数エージェント構成の性能が39〜70%下がりました。中央の確認がない構成では誤りも広がりやすくなりました。[4] 数値はそのモデルと条件のものです。自分の連携が誤りを見つけるか増やすかを確認する必要があります。
出力が独立して直接確認できるなら、別々の担当を使います。再割当て、調査漏れ、食い違う根拠の比較が必要なら主担当を置きます。ある発見が別の課題を大きく変える場合は直接交換を認めます。連絡に大半の労力を使うなら分け方を見直します。
調整役は、誤りが最終回答に入る前に見つけることで役立ちます。
試すための出発点です。仕事で繰り返す問題を解決するときに連携を加えます。
確認できる形で引き継ぐ
「このテーマを調べて」「完了しました」では不十分です。問い、許可する出典とツール、除外範囲、成果物、予算を示します。根拠、未解決の問い、行った変更も求めます。受け手は依頼と照合してから結果を受け入れます。
MicrosoftのMagentic-Oneは、事実・仮定・計画の記録と、現在の割当て・進捗の記録を分けます。停滞を繰り返すと調整役が計画を見直します。[6] メッセージが来たことを進捗とせず、作業が進んだか分かる状態を残す考え方です。
MASTは7つの複数エージェント基盤から1,600件以上の実行記録を集め、設計、連携、完了確認など14種の失敗を整理しました。[5] 自分のシステムでも担当の要約だけでなく、納品ファイルや出典の箇所を見ます。共有記録に識別子と担当を付け、更新の重複を避け、依頼した変更が実際に反映されたか確認します。
仕事全体の費用を数える
検索を同時に行うと待ち時間は減っても計算量は増えるかもしれません。モデル、ツール料金、再試行、重複検索、調整、人の確認、誤りの修正まで数えます。安いモデルでも同じ情報を交換し続けると合計は高くなります。
AI Agents That Matterは、正確さだけの評価が複雑で高価なシステムを有利にし、似た結果を安く得る方法を隠す問題を示します。[7] 同じ課題で品質、経過時間、総費用を比べます。難しい例は別に見ます。平均が妥当でも、修正を繰り返して高くつく実行が隠れることがあります。
担当と全体の上限を決め、繰り返す委任で予算を使い切らないようにします。各担当には必要なアクセスだけを与えます。同じ記録を複数が編集するなら、一つの書込み担当にするか、確実な競合確認を使います。完成した結果に、増えた連携と確認に見合う価値があるか判断します。
結果を見て、構成を変える
代表課題で、まず実用になる最も単純な方法を試します。次に単独エージェントと比較し、明確な分担の利点がある場合に複数を試します。可能ならツール、予算、採点を揃え、結果に影響する違いを説明します。
AgentBenchはさまざまな対話環境でエージェントを評価し、継続的な推論、判断、指示への追従の弱さを示します。[8] 自分の失敗した実行でも最初の重要な誤りを探します。課題の誤解、情報の喪失、ツール選択、確認前の終了のどこでしょうか。全体の点数が悪いから役割を増やすのではなく、繰り返す問題を直します。
成功する経路が決まった順序に落ち着いたら、ワークフローへ移せます。同じ情報を何度も必要とするなら、一つのエージェントに保ちます。独立した作業がいつも完了を遅らせるなら担当を、結果の確認が必要なら調整役を加えます。変更ごとに効果を確かめ、不要になった役割を外せるかも見ます。
仕事が分かるにつれて、仕組みを簡単にできることもあります。