
先看需要完成什么工作
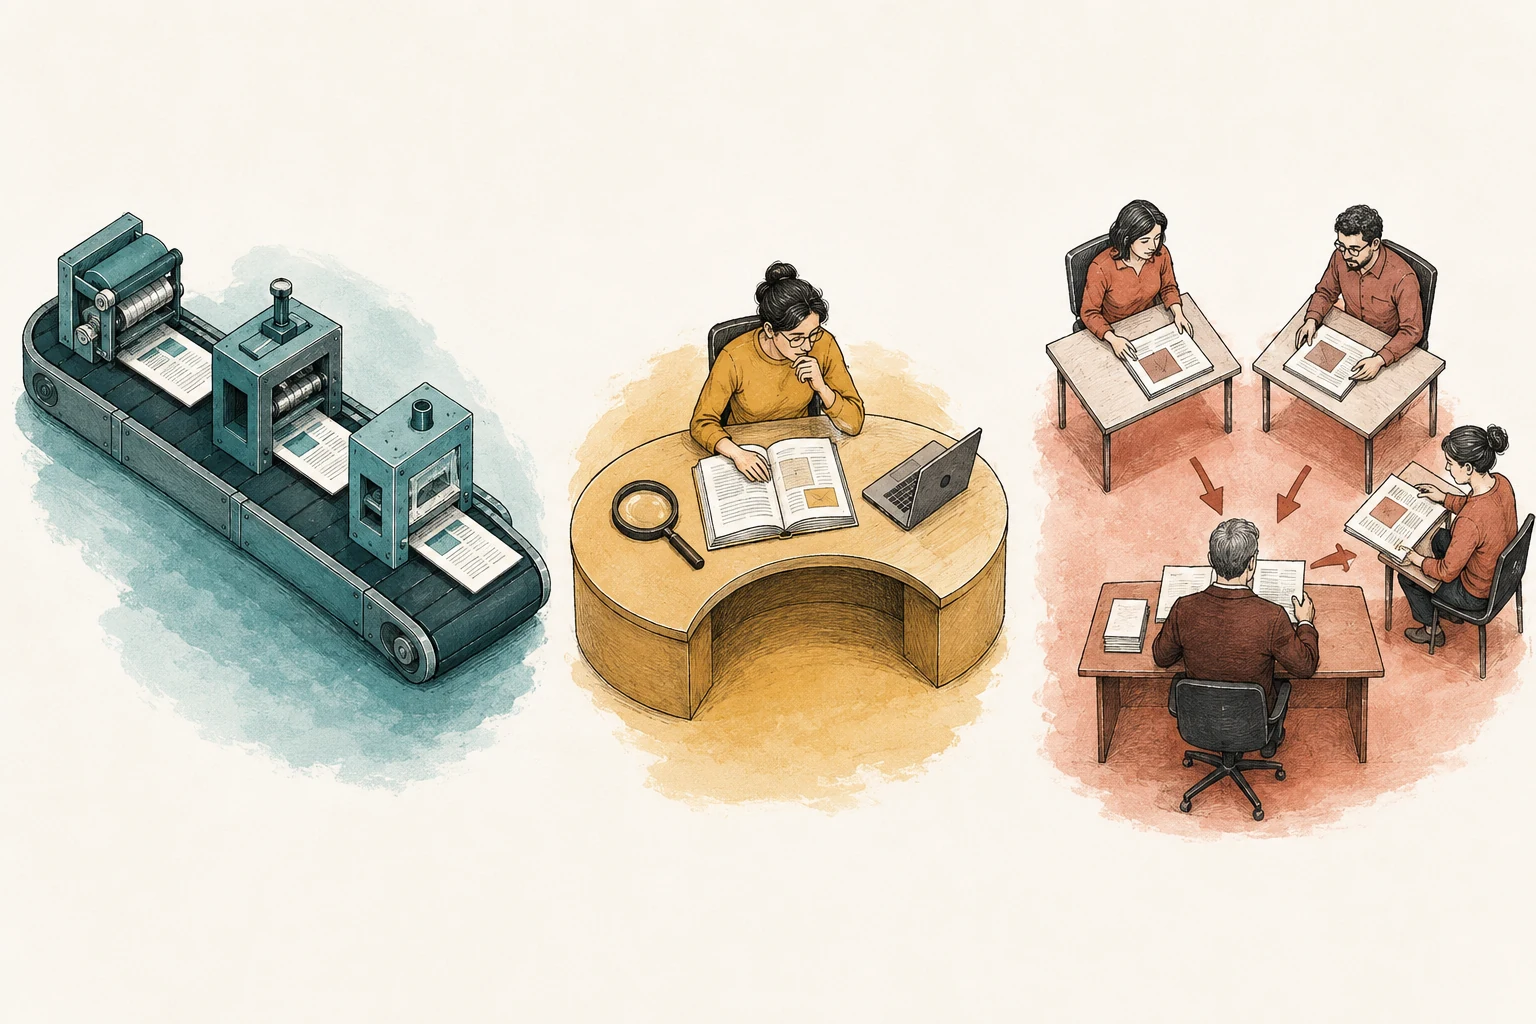
月报每次都按同样步骤进行:收集数字、核对、放进模板。陌生的软件故障要先调查,才知道下一步。多个地区的研究则可能允许分头同时搜索。不同工作需要的灵活程度不同。
工作流沿开发者设定的路线运行。智能体可以根据前面步骤的结果选择下一项行动。多个智能体能分工,但需要人或系统协调结果。Anthropic和OpenAI的指南都建议从简单结构开始,任务需要时再增加复杂度。[1][2]
写明多一个智能体应改善什么:搜索更快、覆盖更多不同来源,还是独立审核更有用?再决定怎样检查改善。如果普通代码或清单就能满足要求,就用它。给每一步起一个智能体名字,并不能证明有收益。
按工作需要选结构,再测它改善了什么。
步骤已知时,用工作流
月报可以明确顺序:取记录、抽取字段、核对合计、起草说明、检查输出。代码能执行顺序,缺必要字段时停止,也能明确人工批准放在哪里。
工作流仍能请模型判断,例如分类文档、起草段落、检查原文是否支持说法。核查失败时,也可以重复步骤。区别在于可走哪些路线、何时结束重复,由开发者定义。
输入和完成标准清楚时,这种方式很合适。计算、权限检查、去重用普通代码,需要解释的部分用模型。如果特殊案例总要新路线,就找出那一段。可以只让受限智能体处理不确定步骤,不必替换整个工作流。
每步依赖刚才的结果时,用一个智能体
调查故障可能需要读日志、提出解释、试一次检查,再调整方向。事先列出所有路径既困难,也未必有用。让系统选择工具并查看结果,才有适应变化的余地。
由一个智能体持续调查,还能把目标、证据、失败尝试和未解决问题放在一起。如果每一步都需要上一步的细节,拆开可能造成反复解释和不完整交接。
给它明确目标、允许的工具、进度记录,以及完成或求助条件。按任务设置时间或费用上限。先提供调查所需权限,发布或删除等操作另行授权。能选择下一步,不等于需要无限权限。
依赖同一份信息的步骤,放在一起处理。
工作能分开时,再增加智能体
研究多个地区时,每个智能体可以用相同问题和报告格式调查一个地区。因为不必等待其他地区的每项中间结果,它们能同时工作。主智能体再检查覆盖并汇总发现。
Anthropic报告,在内部研究评估中,主智能体与子智能体的组合比单智能体对照提高了90.2%。它也报告,多智能体系统使用的词元约为普通聊天的15倍,词元用量解释了很大一部分表现差异。[3] 词元是处理模型输入输出的单位。这些是受测系统与任务的结果,不能证明仅增加智能体就造成了提升,也不能说明所有任务都受益。
拆分前,试着把每项任务写出来。能否靠简短说明开始,不必不断接收其他人的更新就完成,并返回可核查结果?合并时会不会丢重要细节?如果不能,就把相互依赖的步骤留在一起。分成几条消息,不等于能独立运行。
决定怎样核查和合并结果
智能体可以分头返回结果,向负责调整分工的主智能体报告,或直接交换信息。每种安排都会改变谁能发现错误。协调者只有实际核查工作,而不是直接转发所有答案,才有用。
一项智能体扩展研究的2025年初版,在四个基准上测试180种配置。中心协调在可拆分的金融任务中有收益,但受测多智能体配置在串行规划中的表现下降39%—70%。没有中心核查的系统也更容易传播错误。[4] 效果大小只对应该研究的模型和条件。实务中要检查的是:自己的协调机制是在发现错误,还是增加错误?
输出能独立使用并直接核查时,可分给不同执行者。需要重新分配、跟踪遗漏或比较冲突证据时,再设置主协调者。一项发现会实质改变另一项任务时,可以直接交流。如果大部分精力都花在互相更新,就重新考虑拆分。
协调者能在错误进入最终答案前发现它,才有帮助。
这些是供测试的起点。只有协调能解决工作中反复出现的问题时,才增加它。
交接要具体到能够验证
“研究这个主题”不是充分的任务说明,“完成了”也不是充分的返回结果。写明问题、允许的来源和工具、排除范围、所需输出和预算。要求提供证据、未解决问题和作出的改变。接收方对照任务核查后,再接受结果。
Microsoft的Magentic-One把事实、假设和计划的记录,与当前分工和进度的记录分开。反复停滞时,协调者会重新考虑计划。[6] 思路很直接:保留足够记录,判断工作是否真的推进,而不是把又收到一条消息当成进展。
MAST研究提供了来自七种多智能体框架的1,600多条运行记录,并归纳14类失败,包括设计、协调和完成核查问题。[5] 在自己的系统里,应检查交付文件或来源段落,不只读执行者摘要。给共享记录明确标识和负责人,避免重复更新,并确认要求的修改真正生效。
计算整项工作的费用
同时搜索可能减少等待,却增加总计算量。计入模型使用、工具收费、重试、重复搜索、协调和人工审核,也包括纠错工作。几个便宜模型如果反复交换同样上下文,总费用可能更高。
AI Agents That Matter说明,只看准确性可能偏爱复杂昂贵的系统,掩盖取得类似结果的便宜方法。[7] 在同样任务上比较质量、耗时和总费用。困难案例单独看:平均合理,也可能藏着不断修补、花费很高的运行。
为每个执行者和整体任务设上限,避免反复委派耗尽预算。只提供各自任务所需权限。如果多人可能编辑同一记录,就指定一个写入方,或采用可靠的冲突检查。最终成果值得增加的协调与审核,提速才有价值。
根据结果调整结构
先在代表性任务上试最简单且可行的办法,再与单智能体比较;只有明确分工可能有帮助时,才试多个智能体。尽量让工具、预算和评分可比,并解释可能影响结果的差别。
AgentBench在多种交互环境中评估智能体,发现持续推理、决策和遵循指令方面的弱点。[8] 检查自己的失败记录,找到第一个重要错误:误解任务、丢失信息、选错工具,还是验证前就结束?修复反复出现的问题,不要只因总分不理想就增加角色。
成功路径变得固定时,可以把步骤放进工作流。各执行者总需要同样信息时,保留一个智能体。独立任务持续拖慢完成时,再增加执行者;结果需要更仔细审核时,再加协调者。每次调整后重新检查收益,也看哪一层已经可以移除。
越了解工作怎样进行,系统有时越能简化。