
해야 할 일부터 살펴봅니다
월간 보고서는 매번 같은 순서를 따릅니다. 수치를 모으고 확인한 뒤 양식에 넣습니다. 낯선 소프트웨어 오류는 원인을 조사해야 다음에 할 일을 알 수 있습니다. 여러 지역을 다루는 연구라면 지역별 검색을 동시에 진행할 수 있습니다. 일마다 필요한 유연성이 다릅니다.
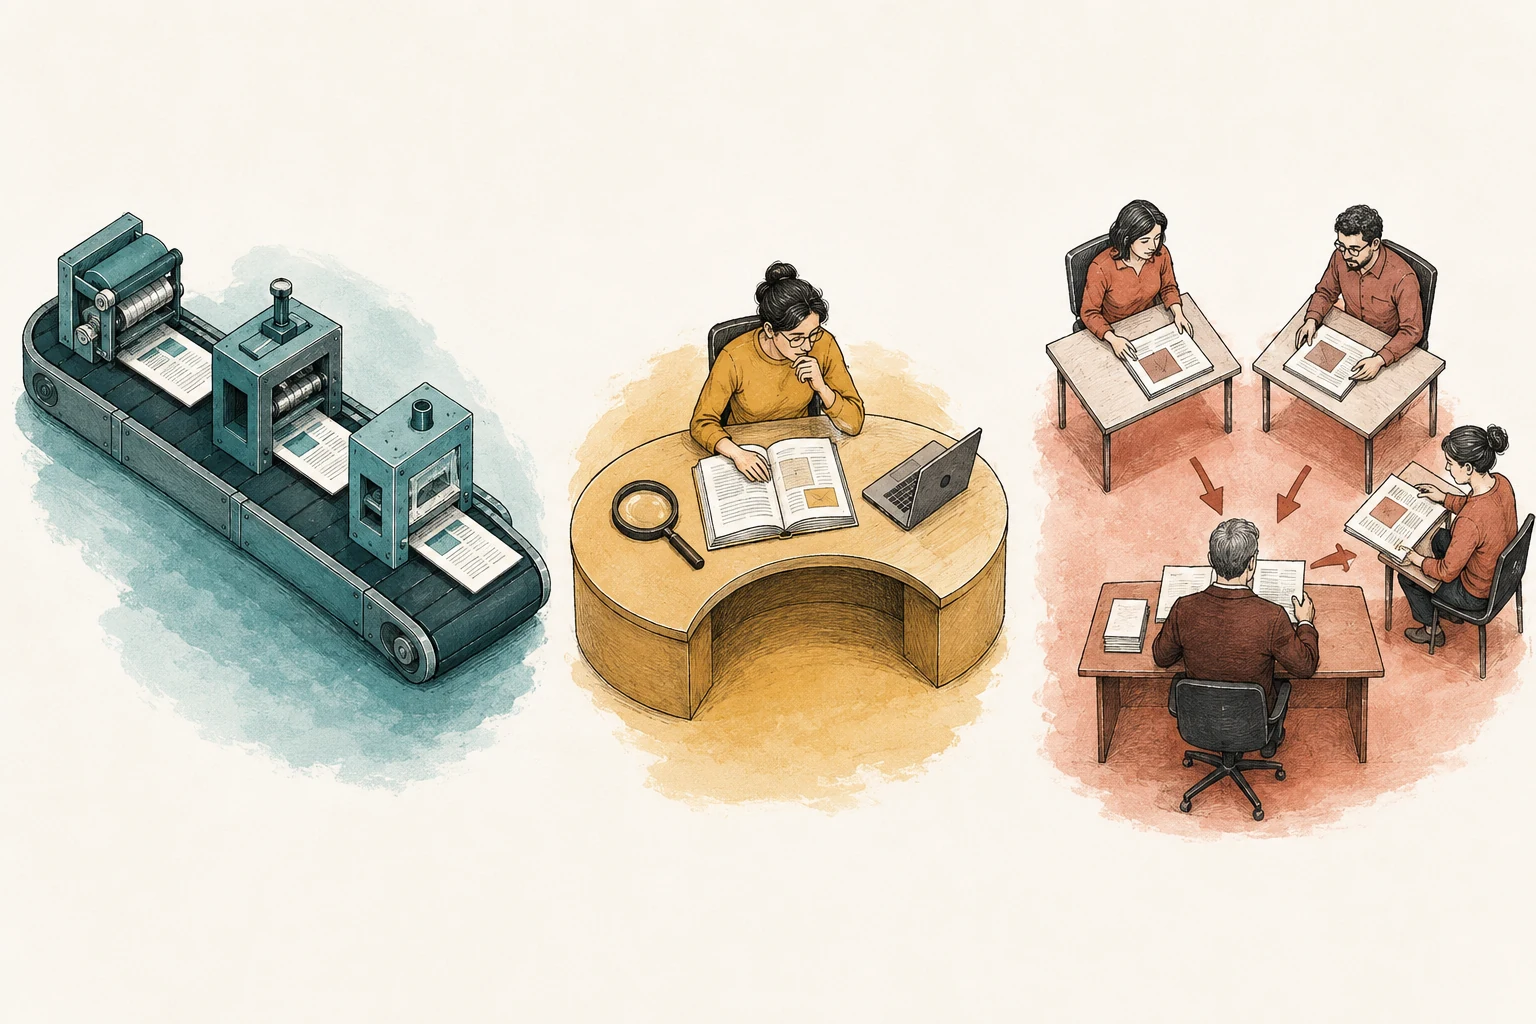
워크플로는 개발자가 미리 정한 작업 순서와 분기 규칙을 따릅니다. 에이전트는 AI가 앞선 결과를 보고 다음 행동을 고를 수 있는 시스템입니다. 여러 에이전트는 일을 나눌 수 있지만 결과를 조율할 사람이나 시스템이 필요합니다. Anthropic과 OpenAI의 지침도 단순하게 시작하고 과제에 필요할 때 구성을 추가하도록 권합니다.[1][2]
에이전트를 더 두면 무엇이 좋아져야 하는지 적습니다. 검색이 빨라지는지, 다른 출처를 더 넓게 살피는지, 독립적인 검토가 유용해지는지 정하고 확인할 방법을 고릅니다. 일반 코드나 점검표로 처리할 수 있다면 그것을 씁니다. 단계마다 에이전트라는 이름을 붙인다고 이점이 생기지는 않습니다.
할 일에 맞춰 구성을 고르고 무엇이 나아졌는지 측정합니다.
단계를 알고 있다면 워크플로를 씁니다
월간 보고서는 기록 가져오기, 필요한 항목 추출, 합계 확인, 설명 초안 작성, 결과 검토로 순서를 정할 수 있습니다. 코드로 이 순서를 지키게 하고 필수 항목이 없으면 멈추게 할 수 있습니다. 사람의 승인을 어디서 받을지도 분명해집니다.
워크플로 안에서도 모델에 판단을 맡길 수 있습니다. 문서를 분류하고 문단을 쓰거나 구절이 주장을 뒷받침하는지 확인하게 할 수 있습니다. 검사에서 실패하면 같은 단계를 반복하게 할 수도 있습니다. 다만 어떤 단계로 넘어갈 수 있고 언제 반복을 멈출지는 개발자가 정합니다.
입력과 완료 조건을 잘 아는 일에 맞는 방식입니다. 계산과 접근 권한 확인, 중복 탐지는 일반 코드로 처리하고 해석이 필요한 곳에 모델을 씁니다. 예외 때문에 새 경로를 계속 만들어야 한다면 어느 단계가 그런지 찾습니다. 전체 워크플로를 바꾸지 않고 그 불확실한 단계만 제한된 에이전트에 맡길 수 있습니다.
직전 결과에 따라 다음 일이 달라지면 에이전트 하나에 맡깁니다
오류를 조사하는 에이전트는 실행 기록을 읽고 원인을 추정한 뒤 시험하고 방향을 바꿔야 할 수 있습니다. 가능한 경로를 전부 미리 나열하기는 어렵습니다. 시스템이 도구를 고르고 결과를 살필 수 있게 하면 상황에 맞춰 대응할 여지가 생깁니다.
하나의 에이전트가 조사를 맡으면 목표와 근거, 실패한 시도, 미해결 질문을 함께 유지할 수 있습니다. 매 단계에 직전 작업의 세부 내용이 필요하다면 일을 나눌수록 같은 설명을 반복하고 인계에서 내용을 놓칠 수 있습니다.
명확한 목표와 허용 도구, 진행 기록, 완료하거나 도움을 요청할 조건을 줍니다. 과제에 맞는 시간이나 비용 한도도 정합니다. 조사에 필요한 접근 권한부터 주고 게시나 삭제 같은 행동은 별도로 허용합니다. 다음 단계를 고르게 한다고 무제한 권한이 필요한 것은 아닙니다.
앞 단계의 목표와 근거가 필요한 일은 같은 에이전트가 이어서 맡습니다.
나눠 끝낼 수 있는 일이 있으면 에이전트를 추가합니다
여러 지역을 연구할 때 같은 질문과 보고 형식을 주고 지역 하나씩 맡길 수 있습니다. 한 지역의 조사에 다른 지역의 중간 결과가 매번 필요한 것은 아니므로 동시에 작업할 수 있습니다. 총괄 에이전트가 조사 범위를 확인하고 결과를 합칩니다.
Anthropic은 총괄과 하위 에이전트를 사용한 내부 연구 평가에서 단일 에이전트 구성보다 90.2% 향상된 성능을 보고했습니다. 또 다중 에이전트 시스템이 일반 채팅보다 약 15배의 토큰을 썼고, 토큰 사용량이 성능 차이의 상당 부분을 설명했다고 밝혔습니다.[3] 토큰은 모델의 입력과 출력을 처리하는 단위입니다. 이 수치는 시험한 시스템과 과제의 결과입니다. 에이전트 수만 늘려서 좋아졌다거나 모든 과제에 유리하다는 뜻은 아닙니다.
나누기 전에 맡길 일을 써 봅니다. 짧은 작업 설명만으로 시작할 수 있나요? 다른 작업자의 중간 결과를 계속 전달받지 않고 끝낼 수 있나요? 결과를 검증하고 중요한 내용을 잃지 않은 채 합칠 수 있나요? 어렵다면 서로 의존하는 단계는 함께 둡니다. 메시지를 나눴다고 일이 독립적으로 진행되는 것은 아닙니다.
결과를 누가 확인하고 합칠지 정합니다
에이전트들이 따로 작업해 결과를 보내거나, 총괄에게 보고하고 배정을 조정받거나, 서로 직접 정보를 나눌 수 있습니다. 구성에 따라 누가 어느 단계에서 오류를 확인할 수 있는지가 달라집니다. 조정자는 답을 그대로 전달하는 데 그치지 않고 실제로 검토할 때 도움이 됩니다.
에이전트 시스템 확장 연구의 최초 2025년 판은 네 벤치마크에서 180개 구성을 시험했습니다. 나눠 처리할 수 있는 금융 과제에서는 총괄 에이전트를 둔 구성이 유리했지만, 순차 계획에서는 시험한 다중 에이전트 방식의 성능이 39~70% 떨어졌습니다. 중앙 검증이 없는 시스템은 오류도 더 쉽게 퍼뜨렸습니다.[4] 효과의 크기는 그 연구의 모델과 조건에 해당합니다. 내 조정 방식이 오류를 잡는지 더 만드는지를 확인해야 합니다.
결과가 각각 완결되고 직접 확인할 수 있다면 작업자를 따로 둡니다. 배정을 바꾸거나 빠진 범위를 살피거나 어긋나는 근거를 비교해야 하면 총괄을 둡니다. 한 발견이 다른 작업에 큰 영향을 줄 때는 직접 소통하게 할 수 있습니다. 서로 근황을 알리는 데 대부분의 수고를 쓴다면 분업을 다시 생각합니다.
조정자는 오류가 최종 답에 들어가기 전에 잡을 때 도움이 됩니다.
시험을 시작할 구성의 예시입니다. 실제로 반복되는 문제를 해결할 때 조율 기능을 추가합니다.
인계할 내용을 검증할 수 있게 씁니다
“이 주제를 조사해 주세요”만으로는 지시가 부족하고 “완료했습니다”만으로는 결과 보고가 부족합니다. 질문과 허용 출처·도구, 제외 범위, 필요한 결과물, 쓸 수 있는 예산을 정합니다. 근거와 미해결 질문, 실제로 바꾼 내용도 보고하게 합니다. 받는 쪽은 지시와 대조한 뒤 결과를 받아들입니다.
Microsoft의 Magentic-One은 사실과 가정, 계획을 담은 기록과 현재 배정·진행 상황을 담은 기록을 나눕니다. 막힘이 반복되면 조정자가 계획을 다시 살핍니다.[6] 메시지가 하나 더 왔다고 진전으로 보지 말고, 어떤 작업을 마쳤고 무엇이 남았는지 알 수 있게 기록하는 방법입니다.
MAST 연구는 일곱 다중 에이전트 프레임워크의 실행 기록 1,600개 이상을 소개하고 설계·조율·완료 검사 등의 실패 유형 14개를 정리했습니다.[5] 내 시스템에서도 작업자의 요약만 읽지 말고 전달된 파일이나 출처 구절을 확인합니다. 공유 기록에는 분명한 식별자와 담당자를 두고 중복 갱신을 피하며 요청한 변경이 실제로 반영됐는지 확인합니다.
작업 전체의 비용을 셉니다
동시에 검색하면 기다리는 시간은 줄어도 총연산량은 늘 수 있습니다. 모델 사용량과 도구 요금, 재시도, 중복 검색, 조율, 사람의 검토를 모두 셉니다. 실수를 고치는 일도 포함합니다. 저렴한 모델 여러 개가 같은 맥락을 거듭 주고받으면 총비용은 더 들 수 있습니다.
「AI Agents That Matter」는 정확도만 평가하면 복잡하고 비싼 시스템을 선호하고 비슷한 결과를 내는 더 저렴한 방법을 놓칠 수 있음을 보여 줍니다.[7] 같은 과제에서 품질과 작업에 걸린 시간, 총비용을 비교합니다. 어려운 사례도 따로 봅니다. 평균은 괜찮아도 수정을 반복하며 비용이 크게 드는 실행이 가려질 수 있습니다.
작업자별 한도와 과제 전체 한도를 정해 반복 위임으로 예산을 소진하지 않게 합니다. 각 작업자에는 맡은 일에 필요한 접근 권한만 줍니다. 여러 작업자가 같은 기록을 고칠 수 있다면 한 작업자만 수정을 맡거나 믿을 만한 충돌 검사를 둡니다. 완성된 결과가 추가 조율과 검토의 수고를 들일 가치가 있을 때 속도 향상도 유용합니다.
결과를 보고 구성을 바꿉니다
대표 과제에서 통할 만한 가장 단순한 방법부터 시험합니다. 에이전트 하나와 비교하고, 일을 분명히 나눌 수 있을 때 여러 에이전트도 비교합니다. 가능하면 도구와 예산, 채점 조건을 맞추고 결과에 영향을 줄 차이는 설명합니다.
AgentBench는 여러 상호작용 환경에서 에이전트를 평가하며 추론을 이어 가는 능력, 결정, 지시 준수의 약점을 찾습니다.[8] 내 실패 기록에서도 처음 발생한 중요한 오류를 살핍니다. 과제를 잘못 이해했나요? 맥락을 잃었나요? 도구를 잘못 골랐나요? 검증 전에 멈췄나요? 전체 점수가 아쉽다고 역할부터 늘리지 말고 관찰한 반복 문제를 고칩니다.
성공한 실행이 예측 가능한 순서로 굳어지면 그 단계를 워크플로로 단순화할 수 있습니다. 작업자들이 같은 정보를 거듭 필요로 하면 하나의 에이전트로 유지합니다. 따로 처리할 수 있는 일이 밀려 전체 작업이 늦어진다면 작업자를 추가하고, 결과 검토가 더 필요하면 조정자를 둡니다. 바꿀 때마다 이점을 다시 확인하고 이제 뺄 수 있는 단계가 있는지도 봅니다.
일의 흐름을 알게 되면 시스템을 더 단순하게 만들 수 있습니다.